はじめに
プラットフォームエンジニアリンググループの山野です。
2026年7月30日(木)〜31日(金)、東京ビッグサイトで開催された Google Cloud Next Tokyo 26 に参加してきました。
基調講演会場は満席で、立ち見席にも人が溢れる状況でした。その他のセッションも基本的に満席で、空き席はほぼありませんでした。日本市場でのGemini / Agentic AI への関心の高さを体感しました。
生成 AI 時代のデータ分析基盤のあり方を掴むべく、イベントに参加してきましたので、その内容と所感をレポートします。
基調講演(DAY1):Gemini Enterprise は「実運用フェーズ」へ
初日の基調講演は、Gemini Enterprise の導入事例と導入企業の活用実態の紹介が中心でした。「これから AI をどう使うか」ではなく「AI はすでに業務に組み込まれ成果を出している」という、実運用フェーズに入ったことを強く印象づける内容でした。
スクウェア・エニックスのマルチモーダル AIの事例紹介
特に興味深かった事例紹介は、スクウェア・エニックスによる Gemini Enterprise Agent Platform を活用したマルチモーダル AI のデモでした。
- ゲームの画面・動画・音声・ゲーム内マップといった複数モダリティを AI が同時に理解し、現状を把握しながらゲームを操作する
- 品質テスト用途のデモでは、AI が現在何を認識し、どう判断したかを画面上に思考として文字表示することで、意図通りに状況把握できているかを可視化する
デモ中、様々なソースから状況把握を行うAI の思考プロセスが表示され、思考の精度が垣間見え、大変興味深いものでした。 AIの思考プロセスを可視化してテスト(QA)を行うというアプローチは、様々な分野に応用できる可能性を感じました。
基調講演(DAY2):AIエージェントの「安全な本番運用」
DAY1がビジネス寄り・事例中心だったのに対し、DAY2の基調講演はAIエージェントを実装・デプロイ・運用するための技術発表が中心となりました。全体を通して、AIエージェントを「安全に本番運用できる」ことをインフラ・エージェント開発・データ・セキュリティという各レイヤーで深掘りする内容でした。
Day 2の内容からデータアナリティクス関連で重要だと感じたポイントをピックアップしてお伝えします。
Borderless Lakehouse
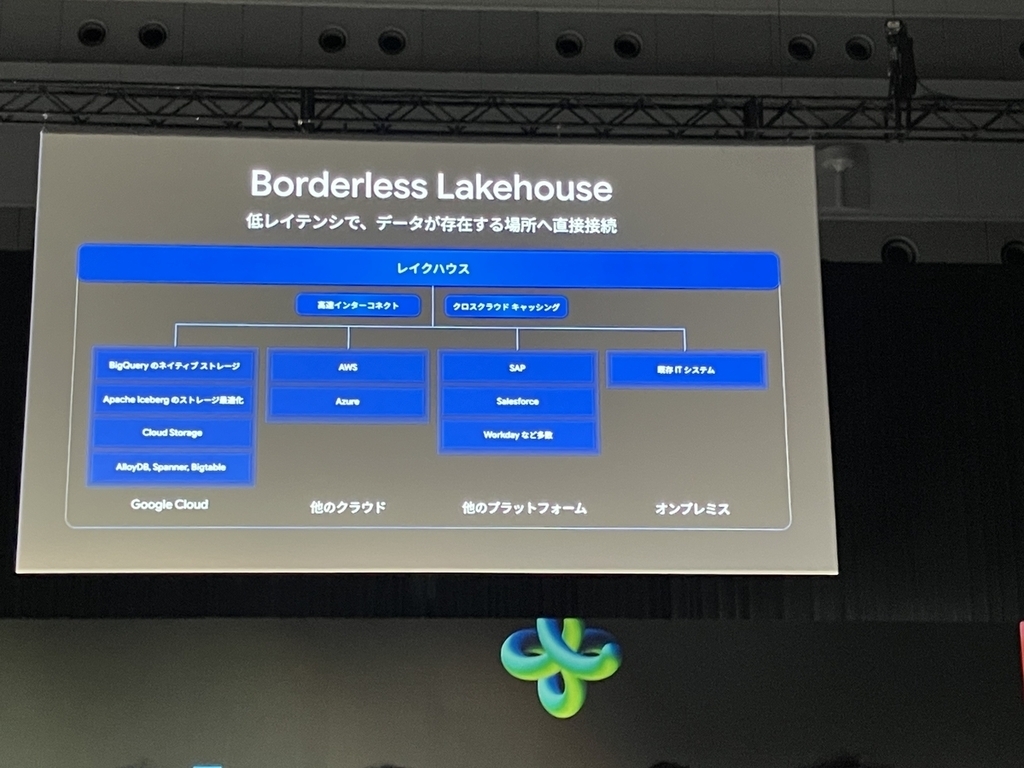
Agentic Data Cloudに関する説明の中でBorderless Lakehouseが紹介されました。マルチクラウド環境に存在するデータをETLパイプラインを構築することなく、Google Cloud から直接クエリできるものです。AWS、Azureだけでなく、アプリケーションレイヤーにも拡張され、SAP、Salesforceなど主要SaaSへも接続可能という構想が革新的でした。
「データがあちこちのクラウドやSaaSに散在している」という、多くの企業が抱える共通の悩みに対する一つの解決策になり得ると感じました。今後どのように現場へ普及していくのか、引き続き動向を追っていきたいと思います。
Knowledge Catalog
Knowledge Catalogは、AIエージェントが推論を組み立てるために常時参照する「実行時コンテキストエンジン」として機能します。 Knowledge Catalog によって企業のコンテキストをAIエージェントが利用できる形で整理する仕組みとその重要性について紹介されました。
「データカタログのメインユーザーは、もはや人間ではなくAIエージェントへ移行した」というのが、今回のKnowledge Catalogに関するメッセージだと解釈しました。 AIに社内データを単に読み込ませるだけでは、背景にあるビジネスルールや依存関係を正しく解釈できず、不正確な推論(ハルシネーション)を招いてしまいます。
Knowledge Catalogが企業の持つセマンティクスをAI向けに整理・提供する「実行時コンテキストエンジン」として機能することで、この課題を根本から解決しようとするアプローチは実践的だと感じました。
データ基盤とAI基盤の両者が密接に連携していく中で、Knowledge Catalogは単なるメタデータ管理ツールを超え、アーキテクチャ上の最重要「ハブ」になっていくと印象づけられる講演でした。
参加セッションのレポート
インフラ主導!Google Cloud と LLM で作るリアルタイム分析基盤
契約書のデータ化オペレーション(OPC)を担う Digitization 部の、インフラチーム 2 名・3 ヶ月で構築したリアルタイム分析基盤の事例が紹介されました。
興味深かったのは、OPC(オペレーションセンター担当)自身がデータエンジニアの業務領域に踏み込めるようになったという報告でした。Cursor のセットアップから、Git/PR 運用(ブランチ作成・動作確認・PR 作成・レビュー対応)、dbt の集計ロジック実装・Mart モデル新規作成、AI エージェントのスキル設計・STG 検証まで、OPC がこなしていくというストーリーでした。
これを成立させていたのが、SKILL によるガードレール設計でした。 (※Google Cloud主体の基盤にしつつ、CursorやClaude Codeも組み合わせた実践的な構成でした)
人間の意図やルールをAIの「スキル」としてリポジトリに構造化し、AIに順守させています。 たとえば、新しいテーブル(Mart)を追加するスキルでは、AIが勝手にデータを作るのではなく、必ず「誰が見るか」「目的は何か」などの問いを人間に投げかける仕組みになっていました。 これにより、ビジネス要件を深く理解しないまま AI が勝手にデータを作ってしまうのを防ぎ、人間に思考を促す「ガードレール」として機能していました。
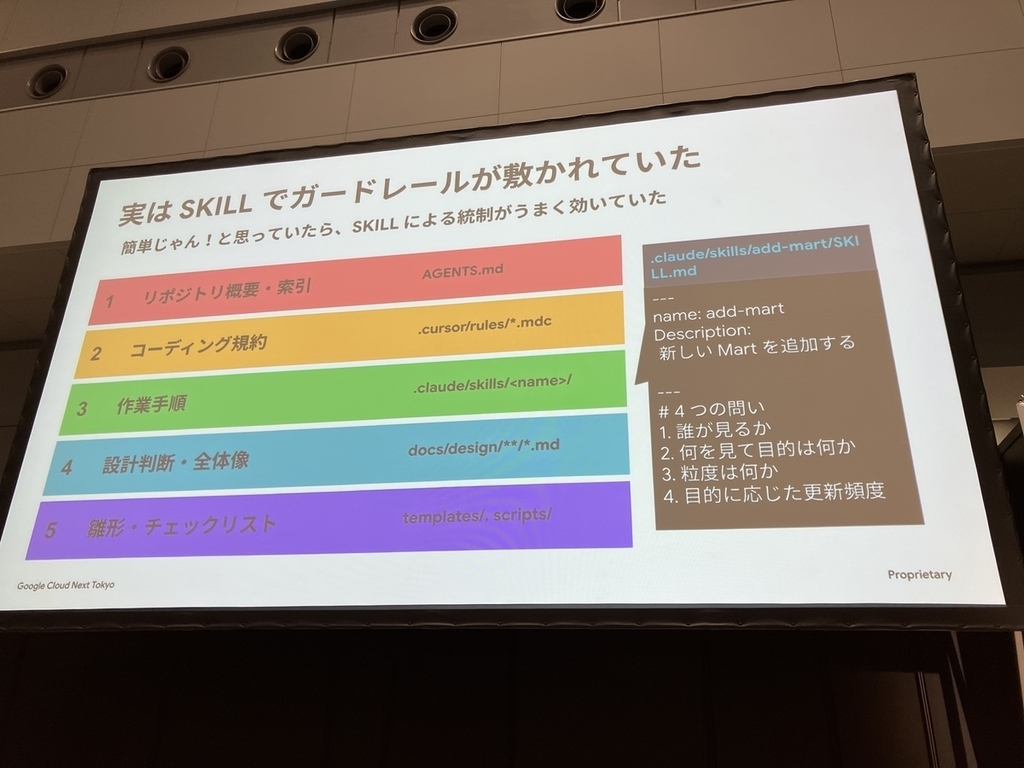
プラットフォームエンジニアリンググループ内でもデータ基盤に関わるメンバーは少人数運用のため、持続可能運用という観点で示唆が大きい発表でした。 「AI をどう入れるか」ではなく「AI が安全に働ける現場をどう設計するか」という視点で、参考になりました。
freee が目指すデータマネジメント戦略:AI-Ready 時代を支える攻めのガバナンスとは
BigQuery を中心とした freee のデータ基盤で、Gemini Enterprise Agent Platform を使った LLM 自動分類とヒューマンインザループを組み合わせた Policy Tag 管理、職種・研修受講状況に応じた動的アクセス制御の実践が紹介されました。
Gemini Enterprise Agent Platformを活用してデータタグを自動分類させつつ、完全にAI任せにせず「人間のチェック・修正(Human-in-the-Loop)」を挟むアプローチが、「AIの得意分野(分類)と人間の責任(判断)」を融合させた、現実的で再現性の高い運用パターンでした。 アクセス権限を「部署」や「役職」といった静的な情報だけでなく、「コンプライアンス研修を受講済みか」などの動的なステータスに応じて制御する設計のアイデアは参考にしたいと感じました。
おわりに
2日間にわたるイベントでは、実践的で切実なテーマが数多く議論されていました。
少人数でデータ基盤を運用している私たちにとって、権限管理の動的化や、安全にデータ開発に携われるガードレール設計(プロンプトや Skill による統制)は、データチームとして得られるものが多い内容でした。単に AI ツールを導入するだけでなく、「AI が安全かつ自律的に働けるデータ基盤」の設計に、今回得た知見を活かしていきたいと思います。
